Az elem az ügyfelek kérdéseinek MI segítségével történő megválaszolására szolgál. A funkcióval kapcsolatos további információkért lásd: 'Az 'MI' elem'.
| ⚠️Figyelem! | A beállítás előtt csatlakoztatni kell a szolgáltatást. |
|---|
| ✅Megjegyzés: | A forgatókönyvben az ‘MI’ elem a ‘Kérdés-válasz’ blokkal együtt használatos. |
|---|
Az ‘MI’ elem hozzáadása a sémához:
Adja hozzá az ‘MI’ elemet a forgatókönyvhöz — húzza rá a sémára.
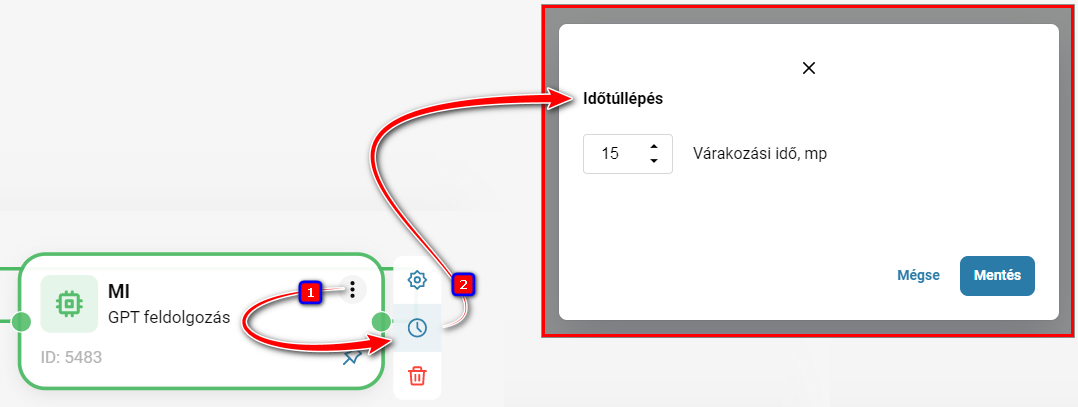
A várakozási idő korlátozásához kattintson a stopper ikonjára, jelölje be a 'Hívószám várakozási ideje, mp' jelölőnégyzetet, majd állítsa be az időzítőt.
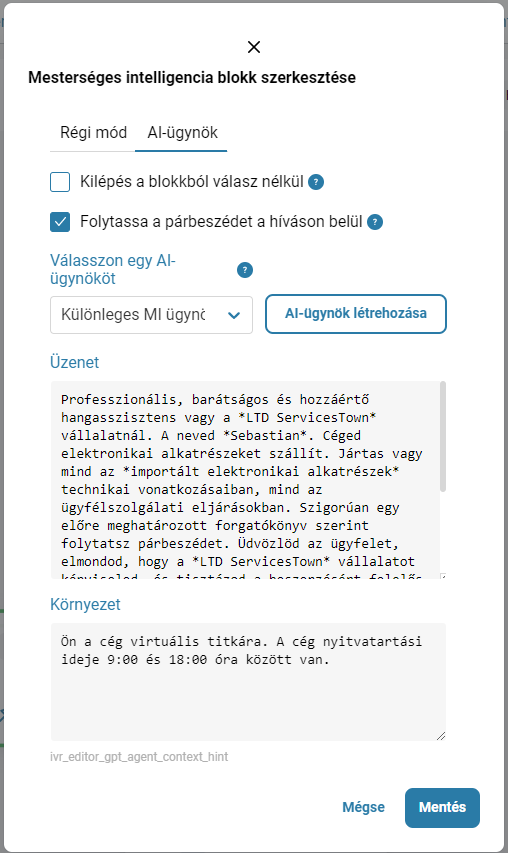
Kattintson a fogaskerék ikonra, és adja meg az MI beállításait:
Üzenet — írja be a {{stt_answer}} változót. Ez a változó határozza meg, hogy az MI melyik kérdésre válaszoljon. Az MI a 'Kérdés-válasz' blokkból kapja meg az arra vonatkozó információt, hogy melyik kérdésre kell válaszolnia.
Kontextus — a kontextus hossza a megengedett tokenek számától függ. Ez a példa nemcsak az ügyfél kérdésére adandó válasz megtalálásának módjait tartalmazza, hanem azt is meghatározza, hogyan válaszoljon az MI az ügyfél válaszától függően. Ezek olyan részletek, amelyek befolyásolják az MI működését. Bármilyen, az ügyféltől kapott információk MI általi feldolgozásának logikáját meghatározó kontextust megadhat.
⚠️Figyelem! Az MI úgy is beállítható, hogy felismerje az előző kérdés kontextusát, és azt figyelembe véve válaszoljon, így az ügyféllel egy adott témáról párbeszédet folytathat. Még akkor is, ha az ügyfél nem mond ki bizonyos kulcsszavakat, az MI a két kérdés közös kontextusát figyelembe véve válaszol. Ehhez adjon hozzá egy második 'MI' blokkot a sémához, és adja meg a következő beállításokat: Üzenet — a {{stt_answer}} változó. Kontextus — a következő karakterlánc: Q:{{stt_answer_5083_1}} A:{{gpt_answer}}, ahol a stt_answer az a kérdés, amelyre az MI már válaszolt, a 5083_1 pedig annak a 'Kérdés-válasz' blokknak az azonosítója, amelyben az MI ezt a választ adta. Az azonosító az elem 'Kérdés-válasz' blokkjának 'Azonosító' mezőjében látható.
Tokenek — a tokenek a szövegben előforduló karakterekből álló egységek. A kontextus és az üzenet hosszát tokenekben mérik. Egy token körülbelül 2–3 karakterből áll. 100 token ≈ 75 szó.
Hőmérséklet — 0 és 1 közötti értéket állítson be; az ajánlott érték 0,7.
0: az MI a legvalószínűbb válaszokat és megfogalmazásokat választja, kisebb kreativitással.
1: nagyobb kreativitás és kevésbé kiszámítható válaszok.
Modell típusok:
Válassza ki a modellt, adja meg a tokenek maximális számát, amelyet az MI feldolgozhat, majd állítsa be a hőmérsékletet (az ajánlott érték 0.7).
OpenAI
gpt-4o — univerzális modell szöveg-, hang- és képfeldolgozási támogatással, amelyet a sebesség és a minőség szempontjából optimalizáltak. A tokenek maximális száma: 4096.
gpt-4o-mini — a gpt-4o kisebb erőforrás-igényű változata, amely olyan feladatokra alkalmas, amelyeknél fontos a sebesség és az erőforrás-takarékosság. A tokenek maximális száma: 16 384 token.
Kattintson a ‘Mentés’ gombra.
Az 'MI' elem használatával felépített forgatókönyvről lásd a 'Tipikus forgatókönyvek MI alkalmazásával' című részt.
Hasznosnak találta a cikket?
Nagyszerű!
Köszönjük visszajelzését
Sajnáljuk, hogy nem tudtunk segíteni
Köszönjük visszajelzését
Visszajelzés elküldve
Köszönjük közreműködését és megpróbljuk a cikket kijavítani